ラベル 機械学習 の投稿を表示しています。 すべての投稿を表示

2020年8月17日月曜日

Dataiku DSS Ver8.0 新機能:Model Document Generation


Dataiku DSS Ver8.0 がリリースされました。

今年の3月中旬にリリースされたDataiku DSS Ver7.0から、更に機能が追加された
Dataiku DSS Ver8.0が7月中旬にリリースされました。
ちょっと調べたのですが、おそらく世界でも早い方の機能レビューではないでしょうか。

詳細については、以下のリンクを参考にしていただくとして、数回に分けてVer8.0の機能をいくつかレビューをしていきます。

DSS Ver8.0 New Features

Model Document Generation

前回はFlow Zonesを紹介しました。今回は、 モデルの結果をMS Wordドキュメントにエクスポートできる、Model Document Generationを紹介します。

データサイエンスではモデル結果を関係者にわかりやすく示す必要があります。Dataiku DSSでもモデル結果を理解しやすいように表示してくれていますが、この結果を他の人(DSSユーザー以外)にも説明をしたい場面もあるはずです。
そのときに利用できるのが、この ”Model Document Generation” です。

実際にダウンロードできるのは、Visual Analysisで結果をダウンロードしたいモデルを選択します。

モデルを選択し、画面右上の「ACTION」をクリックすると、「Export Model Documentation」が表示され、該当のモデル結果がMS Word形式でダウンロードできます。
ダウンロードした結果は以下のようなMS Word形式で表示されます。今回は、Density Chartについて比較をしてみました。

Webの結果では、こんな感じで表示されます。左ペイン中のメニューがMS Word形式にエクスポートしてくれるイメージです。

右にWeb画面のDensity Chartが見られるかと思います。左側はROCカーブでこちらもWeb版に結果が存在しています。

これら以外でも多くのモデル結果をMS Word形式でエクスポートしてくれます。

惜しむらくは、PDF、RMarkdownなど他の形式でのエクスポート機能が充実してくれると嬉しいかと思います。今後のEnhancementを待ちましょう。

ちなみに、こちらはMS Wordのテンプレートを作成してUploadしておくと、それに合わせた結果をエクスポートしてくれる便利機能もあるようです。

聞くよりも実際に触ってみたほうが実感が湧くかと思いますので、ぜひ触ってみてください。フリーエディションはずっと使えて、機能的にも十分に利用することが可能です!

[フリーエディション]


2020年2月21日金曜日

Gartner Magic Quadrant Data Science and Machine Learning PlatformでDataikuがLeaderに!

Gartner Magic Quadrant

毎年この季節になると、Gartnerという調査会社がITの各領域(データベースやビジネス・インテリジェンスツール等)のレポートを発行しています。そのレポートが Gartner Magic Quadrant です。

このレポートの Data Science and Machine Learning Platform という領域でDataiku がはじめてリーダーの位置になりました。


何がスゴイのか?

何がスゴイかというと、業界の中でも「ビジョンの完全性」、「実行能力」を兼ね備えているこの領域でもリーダーの会社です、ということがGartnerによって確認されたということです。

過去はどうだったのか?

2018年11月時点のレポートを見てみると、Dataikuはまだ「CHALLENGER」枠に入っていました。そこから2019年11月時点では「LEADER」の位置に来ています。
1年足らずでLEADERの評価を得られるようになってるようです。


2018年、2019年と比べてみると一目瞭然ですが、全体的に「ビジョンの完全性」の方向によってきていて、「実行能力」があるかないかで別れているようです。

この数年でData ScienceやML Opsなどで「何をしなければいけないかの課題」が明確化されつつあり、それに対して各社対応しているため、ビジョンの完全性に寄ってきているのではないかと推測します。


2020年1月3日金曜日

Dataikuを使ってみよう #5 DataikuのAutoML (クラスタリング)

前回まで

前回までは、データインポート、データハンドリング、データ分割、機械学習の適応(複数のアルゴリズムを適応:Prediction(予測))について説明をしてきました。
今回は機械学習の適応の続き、クラスタリングについて説明をします。
(各クラスタリングのアルゴリズムの説明はここでは行いません。別の参考資料等にてご確認ください)

クラスタリングとは

クラスタリングとは、一般的には以下のような説明がされています。
クラスタリングではデータの集合を部分集合(クラスタ)に切り分けて、それぞれの部分集合に含まれるデータが(理想的には)ある共通の特徴を持つようにする。この特徴は多くの場合、類似性や、ある定められた距離尺度に基づく近さで示される。https://ja.wikipedia.org/wiki/%E3%82%AF%E3%83%A9%E3%82%B9%E3%82%BF%E3%83%AA%E3%83%B3%E3%82%B0
手元にある大量のデータが、グルーピングがされておらず、なんらかの知見を得たい場合、グループに分けることで知見が発見できる場合があります。そのような場合に、このクラスタリングは重要です。

Dataikuでのクラスタリング

では、Dataikuではどのようにクラスタリングを行うのでしょうか。
前回と同様に、以下のユースケースを用いてクラスタリングをしてみましょう。
Predictive Maintenancehttps://academy.dataiku.com/latest/usecases/L01C01/index.html
前回と同様に、
  1. クラスタリングをさせたいデータセットを選択
  2. 右ペイン中の「LAB」をクリック
  3. QUICK MODEL を選択 します。
そうすると、以下の画面(Choose your Task)が表示されるので「CLUSTERING」を選択します。
Clusteringを選択すると、以下の画面にうつります。ここでは、Quick Modelを選択しましょう。

次の画面では、どのようなクラスタリングを行いたいかを選択できます。ここでは、
  • K-Means(一般的なクラスタリング手法)
  • Interactive Clustering (一度モデルを作成した後、手動で調整ができる2段ステップ
  • Anomaly detection (異常値検知)の3種類から選ぶことができます。
今回は、K-meansを選択してみます。

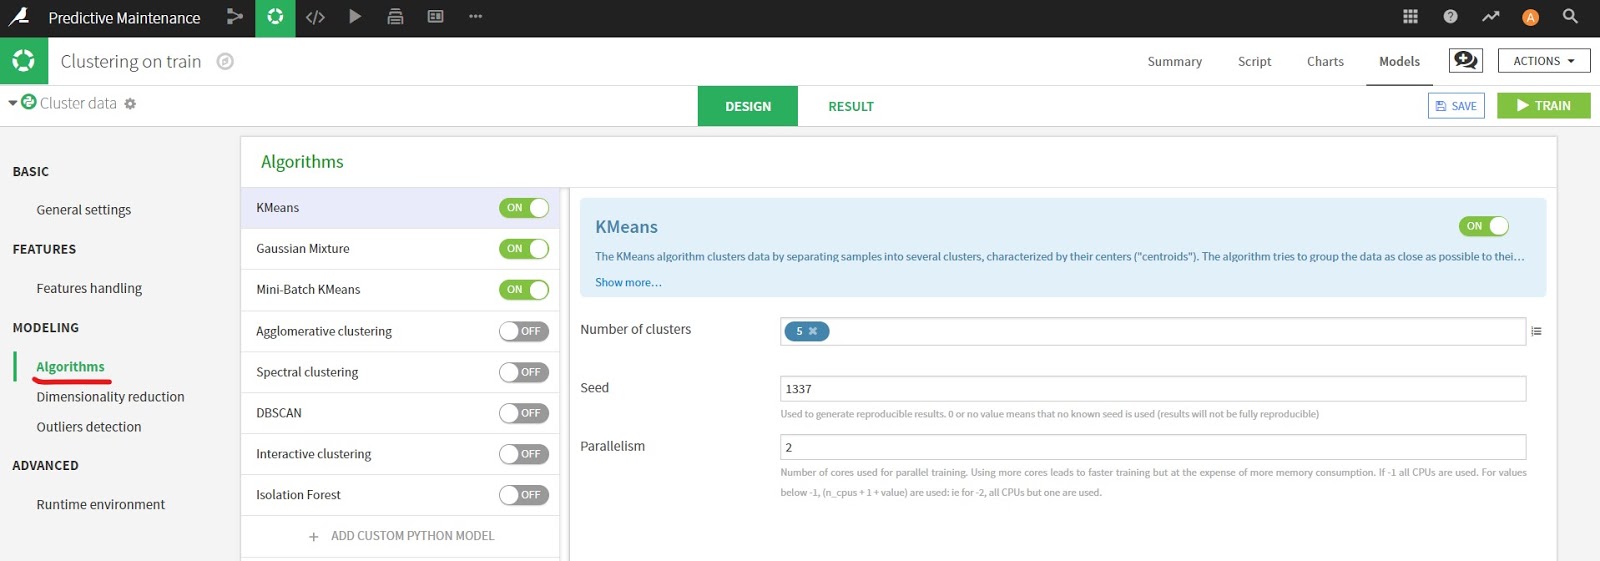
次の画面では、クラスタリングの設定画面となります。前回紹介した設定画面と同様に、どの変数を加えるか、どのアルゴリズムを適応するかなどを設定することができます。
今回は主だった設定項目を紹介します。

General Settings では、学習データセットのデータをどのようにサンプリングするかを指定できます。サンプリング以外でもすべてのデータを使うことも選択できます。


Feature Handlingでは、クラスタリングの学習に必要な変数をON、OFFできます。
ここでも選択した変数の内容を右ペインで確認することができます。欠損地の扱いや、この項目に含まれる値がどのような分布になっているかを一目で確認をすることができます。

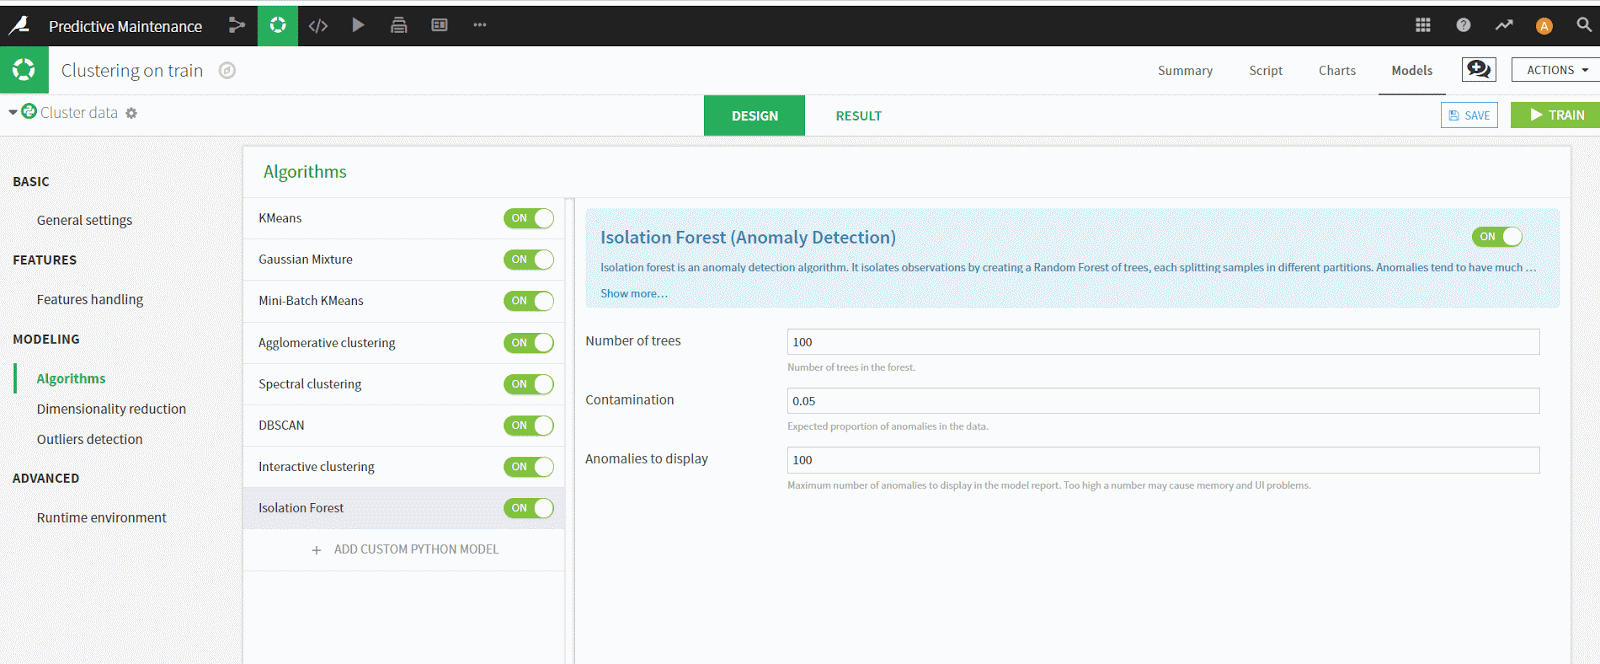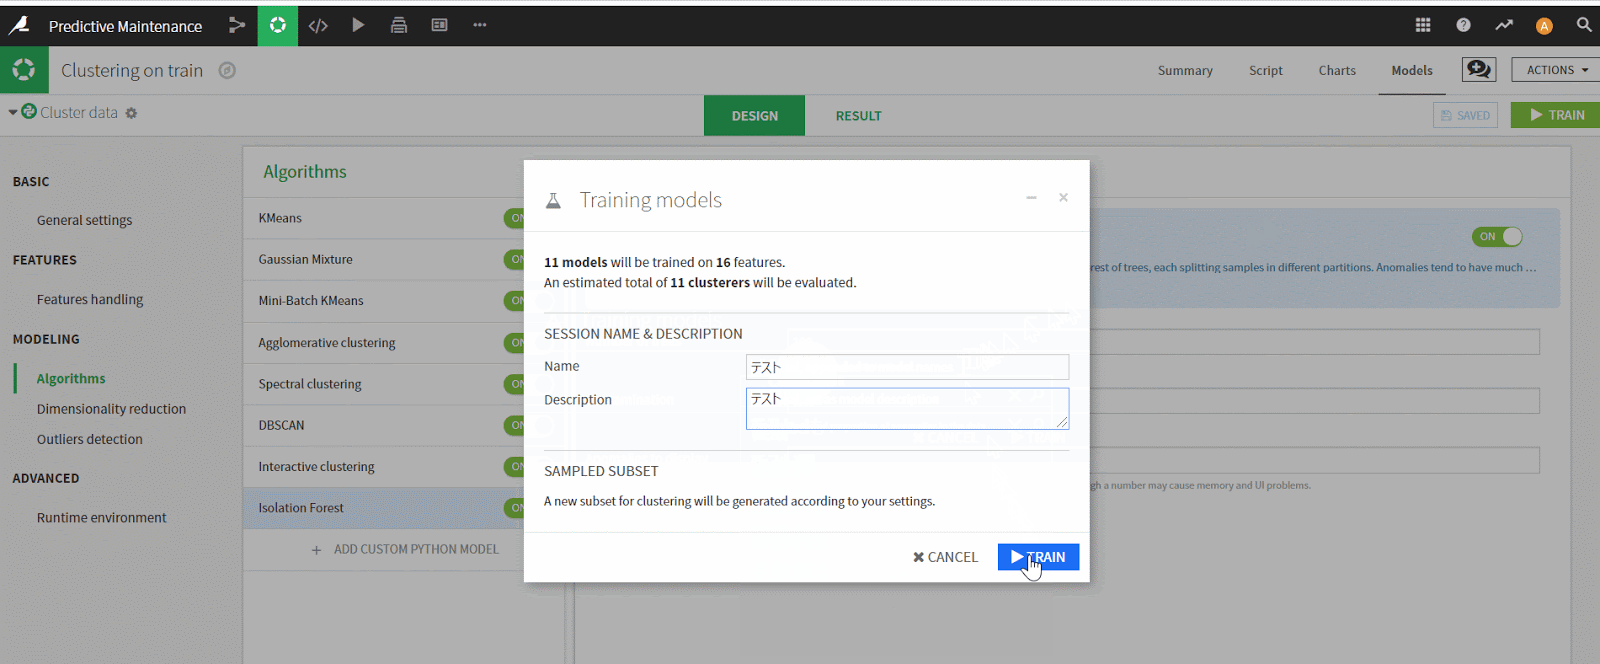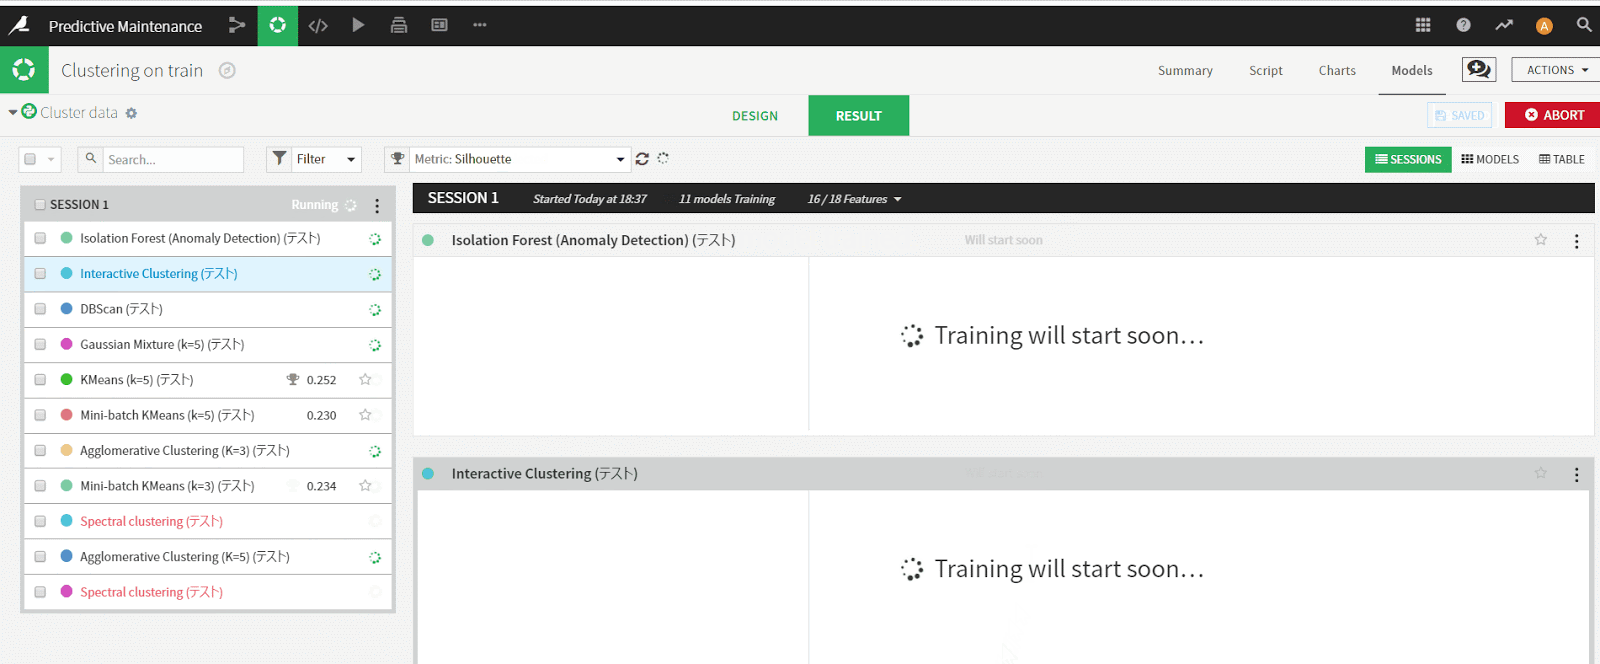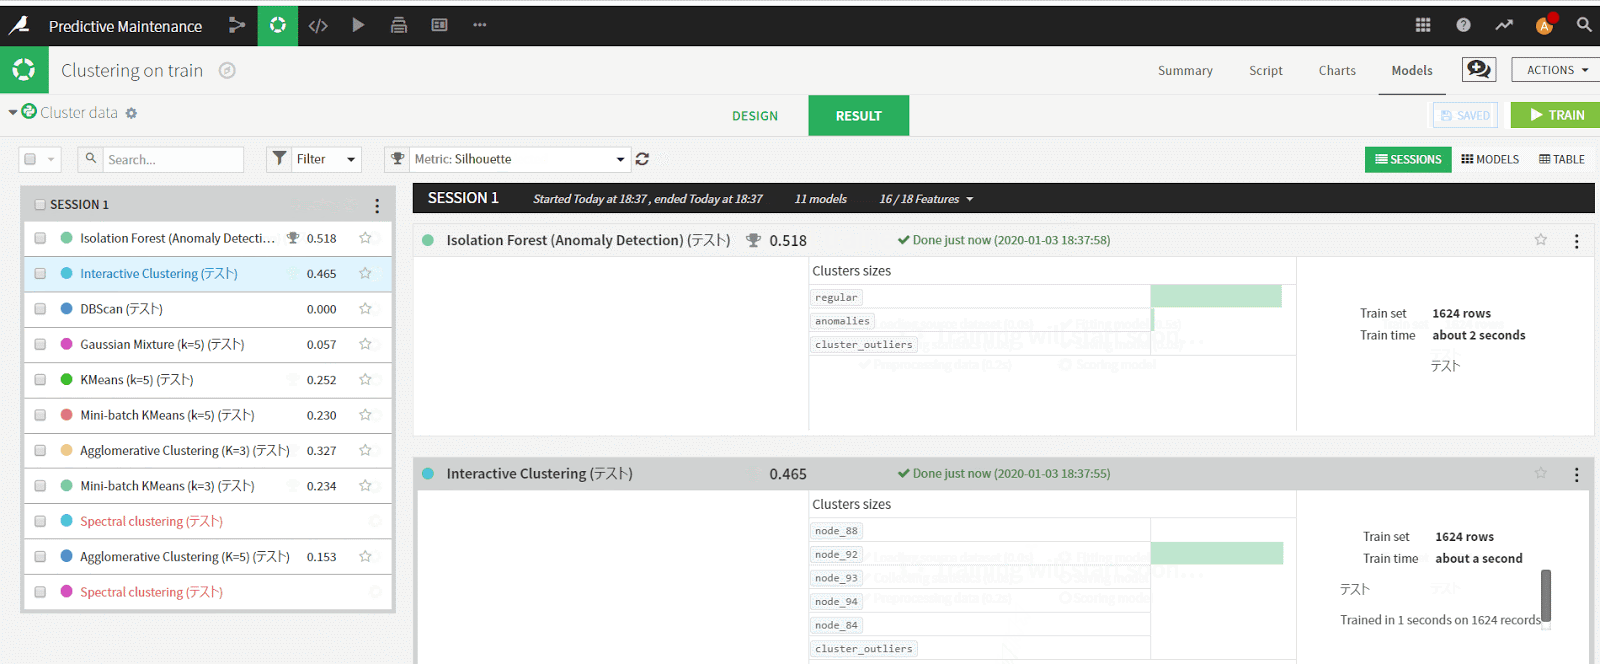
Algorithm の部分では、クラスタリングに関連するアルゴリズムを選択できます。前回のPredictionと同様に、適応させたいアルゴリズムをONにするだけで適応してくれます。また固有のパラメータも設定することが可能で、個々のアルゴリズムをカスタマイズして適応をさせられます。


続いては、Dimensionality reduction (次元削減)です。 ここでは、PCAを元にした次元削減を行うか、行わないか、両方とも試してみるか?の3択を選択することができます。

最後は、Outlier Detection (外れ値をどのように扱うか)を選択できる画面です。
Dataikuでは外れ値を検出できるのですが、それをどのように扱うか、データから落とすか、外れ値用のクラスタを作成するか、外れ値を検出しないかを選択することができます。必要に応じて設定してみてください。


では、実際に実行をしてみましょう。
実際に複数のアルゴリズムが実行がされている様子が確認できるように動画にしてみました。
以下の4点のアクションが含まれています。
  1. 複数のモデルを選択
  2. 右上のDeploy ボタンをクリック
  3. 後で区別ができるように名前を入力し、実行
  4. 各アルゴリズムが実行される


アルゴリズムの実行が終わると、Predictionと同様に結果を見ることができます。
今回は、K-means アルゴリズムの結果を見てみます。

Summaryでは、投入したデータがどのように分類してくれたのかを確認できます。ここではクラスタの名称やその説明を入力することができます。右上にChartsがあり、この結果を使ってグラフを作成することができるので、分類された内容を様々な角度から見ながら名称を決定していけばよいかと思います。

次にValuable Importance です。 どの変数がクラスタを決定づけるのに重要だったのかを知ることができます。

Heatmapでは、各変数がどのクラスタにどのぐらい影響を与えているかがヒートマップの形で表現されています。

Cluster Profileでは、各クラスタの変数の分布が表示されます。

Scatter Plotでは、縦軸・横軸を分析した変数を指定することができ、Clusterがどのように分布しているのかが分かります。以下のチャートでは、count変数が一番聞いていることがImportanceから分かっており、それをX軸、Y軸にDistanceを置いて散布図を作成しています。散布図の点にClusterの色を配置しているため、どのようにClusterが分布しているのかが一目でわかります。


Detailed Metricsは、今回用いた評価用のスコアを表示します。(今回はSilhouetteを使いました)


このように、K-meansだけでも多くのアウトプットを表示しており、アルゴリズムの実行結果の解釈に大いに役に立つのではないかと考えられます。K-means以外のアルゴリズムも同様な結果を表示しています。(これ以外でもModel Informationとして数種類結果が表示されています)

2019年10月27日日曜日

Dataikuをはじめてみよう


「dataiku」の画像検索結果

近年のデータアナリスト・データサイエンティスト ブームで、この職種が何をやっているのかが世の中に認知されはじめているようです。

  • データハンドリング:機械学習へ適応させやすくするための加工
  • データモデリング:データを何らかのモデルに適応させ、結果を取得する
  • 結果の判定・シェア:どのモデルが良かったのかの判定と、関係者への説明
    等々
ただ、これらの仕事を行うには、専門的なスキルセット(SQLやPython、Rなど)を扱う必要があり、且つ習熟している人でもそこそこ骨の折れる、時間がかかる仕事です。

その解決策を行ってくれるソフトウェアがありました。古くは SAS Enterprise Miner、
最近だと、KNIME、Alteryx 等が出てきました。

今回紹介するのは、その中でも昨年末におよそ1億ドル(約100億円)単位で調達を行い、いま最も注目されているデータ分析ツールの Dataiku をご紹介します。

Dataikuとは
Dataikuとは、上記のようにデータアナリスト・データサイエンティストの業務を解決してくれるソフトウェアです。クラウド上のソフトウェアではなく、クライアントPC(Mac,Windows)でも動作をしてくれます。
「dataiku flow image」の画像検索結果
詳しくはこちらのコンセプトはこちら。
https://www.dataiku.com/dss/index.html

基本的なコンセプトとしては、データ分析のコラボレーションが可能なコンセプトで、作られていて、データエンジニアやデータアナリスト、データサイエンティスト、はたまたマーケティングの人が同じ環境を利用してそれぞれの仕事をできるという点が大きな特徴です。
しかも、ほとんどの内容をマウス一つでできる環境になっていて、PythonやR、SQLを知らない方でも利用できるのも大きな特徴です。

Editionと利用環境

Dataikuは期限つきのフリーではなく、「完全にフリー(一部制限機能付き)」のソフトウェアをダウンロードできます。
私はこのEditionをAWSのEC2上に構築をしています。
個人的にはEC2の t3a.xlarge を使っています。当初はAWSのフリー枠を使って見たのですが、1GBのメモリだと正しく動作しないようです。推奨は16GBのメモリーが必要とのことです。
[Q&A]
https://answers.dataiku.com/4662/error-on-new-uploaded-data-files-datasets
[System Requirements]
https://doc.dataiku.com/dss/latest/installation/requirements.html


個人的に感じたとても良かった点

フリーエディションを使ってみて、以下の点についてはとても気に入っています。
  1. 多種多様なデータソースへの接続
    Traditionalなデータソース(Oracle,Teradata,Vertica等)だけでなく、AWS S3 やHadoop、Hiveなどモダンなデータソースへの接続もできます。
    * フリーエディションでは一部接続ができないデータソースもあります。
  2. データハンドリングのしやすさ
    データアナリスト・データサイエンティストの方が直面する「データハンドリング」。データを結合したり、欠損値を補完したり、計算した結果を新たなカラムに作り出したり、縦横変換したり… と多くのことを従来であればコードベースで行う必要がありました。
    Dataikuでは「Visual recipe」という機能を使うことでデータ加工が簡単に行えます。データの分割(Train、Test)、データの結合、縦横変換、変数の加工(欠損値加工や関数の適応、Geocoding、Window関数) 等々 データハンドリングに必要なものはほとんど揃っています。コードを書かずともこれらの操作ができるのはデータ加工業務を大幅に短縮できそうです。
  3. カラム中のデータ分布が見やすい
    データ分析を始める前にデータ加工の一貫で実際のデータの中身の分布がどのようになっているかを調べるかと思います。従来であればスクリプトで確認をして変更をして…という調査と変更を行う必要があるのですが、Dataikuの Analyze 機能を使うことにより、一発で項目に何が入っているかを把握することができます。
    また、上記のVishal recipeを使うことで値を変更することも可能です。
  4. 複数のモデルを一気に回せる
    データの確認、機械学習用のデータセットが完了したら次はモデリングです。従来のPythonやRの場合は一つのモデルに対して一つずつコードを書かなければいけないのですが、Dataikuの場合は組み込み済みモデルがあり、それらを選択でき、一度に回すことができます。もちろん、どの変数を説明変数にするか、変数をどのように追加するか(線形結合・多項式結合)、変数をどのように減らすのか(変数選択)等の設定も可能です。ここのあたりは最近流行りのAutoMLの機能にあたるでしょうか。
    各モデルの細かなパラメータチューニングも可能で、値を設定したりすることも可能です。この組み合わせは残すことができ、何回も試行錯誤できる作りになっています。
  5. RやPythonのコードを組み込むことができる。
    準備済みのVisual Recipeやモデルでも物足りないケースが出てくるかと思います。またインポートしたデータセットを使ってEDA(探索的データ分析)を使い慣れた言語(RもしくはPython)で分析したいと思うかもしれません。
    そんな人にもJupyter Notebookで分析ができる環境が用意されています。
    また、そのままフローに追加することも可能です。また、RMarkdown、Shinyも作成することができます。
    * 以下は、Dataiku上のJupyter NotebookでRでggplot2を表示している
  6. 関係者との共有がしやすい
    これまでの分析結果の共有では、チャートや分析結果をプレゼンテーションにする、Excelでまとめてシェア、最近だとRではRMarkdownでレポート作成等を行っていると思います。Dataikuではそのような別のアプリケーションにデータやチャートを移す必要なく、Dashboardで共有することができます。
    あらゆるFunctionからDashboardへPublishすることができ、関連するユーザーはこのDashboardを見ることにより、モデルの結果や分析コメント等を見ることができます。
これ以外でもDeep Learningや、時系列分析、Vishal Recipeを追加できるAdd-onなどの機能が充実しています。

惜しむらくは、まだ日本語へのローカライゼーションができておらず、英語のみ(ツールもWebサイトも)の利用しかできないことでしょうか。

実際に使ってみよう

習うより慣れろ。の言葉通り、実際に触ってみたほうが早いと思います。
フリーエディションをインストールされるもよし、DataikuのWebサイトにはデモとして利用できるページもありますので、それを触ってみてもよし。
実際に利用してみて、Dataikuの良さを実感してみてください。

また、機能が多いため、最初からすべてを一気にできないので、チュートリアルを一つずつやってみて、まずは全体的な流れを覚えていただくのがオススメです。

[フリーエディション]

今後の予定

今後はDataikuを使う際のTipsやナレッジ、Kaggleでのチャレンジなどを載せていく予定です。